Turing, 1950 : il propose un test, 75 ans plus tard les LLM le passent, et ce n’était pas la bonne question
En 1950, Alan Turing remplace la question « les machines peuvent-elles penser ? » par un jeu : une machine peut-elle passer pour un humain ? En 2025, un modèle de langage réussit ce test. Et l’on découvre qu’il ne mesure pas ce qu’une organisation a besoin de savoir.
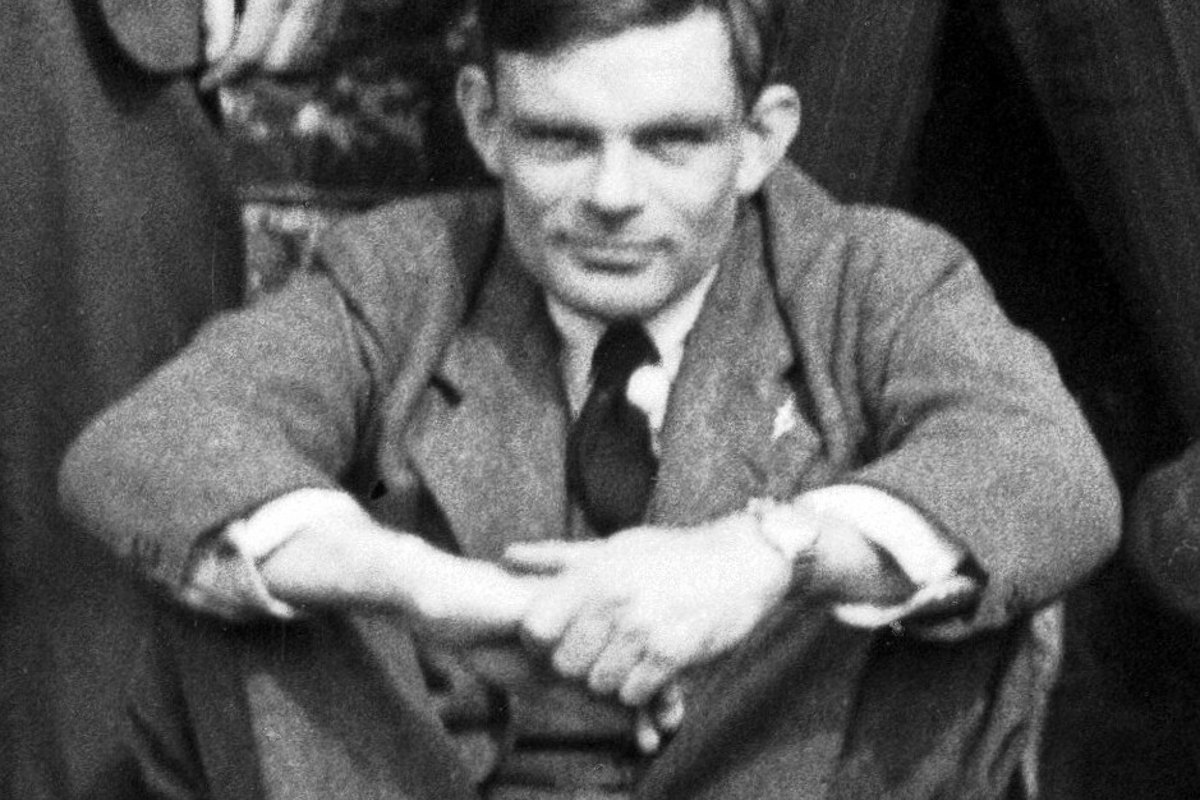
En octobre 1950, la revue de philosophie Mind publie un article de 28 pages signé A. M. Turing. Son titre : « Computing Machinery and Intelligence ». Sa première phrase : « I propose to consider the question, “Can machines think?” » Je propose d’examiner la question : les machines peuvent-elles penser ?
Soixante-quinze ans plus tard, un modèle de langage a passé, dans une étude contrôlée, le test que Turing proposait dans cet article. Et la leçon la plus utile n’est pas celle qu’on attendait. Ce test mesure si une machine paraît humaine. Il ne dit rien de ce qu’on peut lui confier.
Remplacer une question floue par un jeu
Turing ne répond pas à sa propre question. Il explique qu’en partant du sens courant des mots « machine » et « penser », on finirait par chercher la réponse dans un sondage, ce qu’il juge absurde. Il remplace donc la question par un jeu, qu’il appelle le jeu de l’imitation.
Dans sa forme d’origine, le jeu se joue à trois : un homme, une femme et un interrogateur, installé dans une autre pièce. L’interrogateur pose des questions par écrit, idéalement par téléscripteur, pour que la voix ne trahisse personne. Il doit deviner qui est l’homme et qui est la femme. L’homme cherche à le tromper.
Puis Turing pose la vraie question : que se passe-t-il quand une machine prend la place de l’homme ? L’interrogateur se trompera-t-il aussi souvent ? Ces questions, écrit-il, remplacent la question d’origine.
Plus loin, il formule un pari précis :
« I believe that in about fifty years’ time it will be possible to programme computers, with a storage capacity of about 10⁹, to make them play the imitation game so well that an average interrogator will not have more than 70 per cent. chance of making the right identification after five minutes of questioning. »
Autrement dit : vers l’an 2000, après cinq minutes de questions, un interrogateur moyen n’aurait pas plus de 70 % de chances de reconnaître la machine. Dans la même page, il ajoute que la question d’origine, « les machines peuvent-elles penser ? », lui paraît « trop dénuée de sens pour mériter discussion ».
Le détail que l’on oublie : la machine se trompe exprès
Pour illustrer son jeu, Turing donne quelques exemples de questions et de réponses. L’un d’eux mérite qu’on s’y arrête :
« Q: Add 34957 to 70764 / A: (Pause about 30 seconds and then give as answer) 105621. »
Faites le calcul : 34 957 plus 70 764 donnent 105 721, pas 105 621. Dans l’exemple choisi par Turing, la machine attend trente secondes, comme un humain qui compte de tête, puis donne un résultat faux.
Ce n’est pas une coquille. Quelques pages plus loin, il répond à l’objection selon laquelle une machine se trahirait par sa précision en calcul. Sa réponse : la machine programmée pour le jeu « n’essaierait pas de donner les bonnes réponses aux problèmes d’arithmétique. Elle introduirait délibérément des erreurs, de manière à embrouiller l’interrogateur ».
Tout est là, dès 1950. Le test récompense l’imitation. Une machine qui veut le réussir a intérêt à paraître humaine, y compris dans ses erreurs. Le test ne demande jamais si la réponse est juste.
Turing répond aussi à Ada Lovelace
L’article passe en revue neuf objections à l’idée d’une machine qui pense. La sixième porte le nom d’Ada Lovelace. Dans ses notes sur la machine analytique de Babbage, que Turing cite, elle écrivait que la machine « n’a aucune prétention à créer quoi que ce soit » et qu’elle peut faire « tout ce que nous savons lui ordonner d’exécuter ».
Turing lui répond avec humour : « Machines take me by surprise with great frequency. » Les machines le surprennent souvent, explique-t-il, parce qu’il ne fait pas assez de calculs pour prévoir ce qu’elles vont faire. Le débat entre les deux tient encore aujourd’hui : un modèle de langage ne fait que ce que ses données et son entraînement permettent, et pourtant ses réponses surprennent ceux qui l’utilisent.
2025 : le test est passé
En mars 2025, Cameron Jones et Benjamin Bergen, chercheurs en sciences cognitives à l’université de Californie à San Diego, publient une étude intitulée « Large Language Models Pass the Turing Test ». Le protocole reprend la version à trois du jeu : chaque interrogateur discute cinq minutes, en même temps, avec un humain et avec une IA, puis désigne celui qu’il croit humain.
Les chiffres, sur 284 participants et 1 023 parties analysées :
- GPT-4.5, avec une consigne de personnage (un jeune introverti, familier de la culture internet, qui parle argot), est jugé humain 73 % du temps. Plus souvent que les vrais humains en face.
- LLaMa-3.1-405B, avec la même consigne : 56 %.
- Sans consigne de personnage, GPT-4.5 tombe à 36 %.
- ELIZA, le programme de 1966, obtient 23 %, et GPT-4o sans consigne 21 %.
Les auteurs y voient la première preuve empirique qu’un système artificiel passe un test de Turing standard à trois participants. Il s’agit d’une prépublication, mais le protocole est préenregistré et répliqué sur deux populations.
Ce que les interrogateurs ont vraiment testé
La partie la plus instructive de l’étude n’est pas le score. C’est l’analyse de ce que les interrogateurs ont fait. Dans 61 % des parties, ils ont fait la conversation : métier, journée, activités. Dans la moitié, ils ont parlé d’émotions, d’opinions, d’humour. Les connaissances et le raisonnement n’ont été testés que dans 12 % des parties.
Leurs verdicts reposaient d’abord sur le style (une faute de frappe, un langage « plus humain ») et sur la fluidité de l’échange. Certains ont choisi un témoin parce qu’il avait fait une erreur, ce qui le rendait plus humain. Exactement le mécanisme décrit par Turing en 1950.
Le résultat montre deux choses. Les modèles actuels imitent très bien la conversation humaine. Et ce qui rend une IA convaincante n’a presque rien à voir avec ce qui la rend fiable.
Ce que ça change pour une organisation
Je vois cette confusion dans beaucoup de projets. Un assistant est choisi parce que la démo était fluide, que le ton était juste, que les réponses « avaient l’air bonnes ». Personne n’a compté combien étaient exactes.
Le test de Turing pose la question : peut-on la distinguer d’un humain ? Pour une organisation, la question utile est autre : sur cette tâche précise, avec nos données, à quel taux d’erreur, et qui corrige quand elle se trompe ?
Concrètement, avant de confier une tâche à un outil d’IA :
- Cadrer la tâche. Une tâche précise, avec un résultat vérifiable : classer une demande, extraire un montant, préparer un brouillon de devis.
- Constituer un jeu de test. Une centaine de cas réels, avec la bonne réponse connue, y compris les cas difficiles.
- Mesurer. Taux de réponses exactes, erreurs graves, temps gagné, part des réponses reprises par un humain. Le ton de l’outil n’entre pas dans la note.
- Nommer un propriétaire métier. Quelqu’un qui décide des seuils acceptables et qui suit les chiffres dans la durée.
J’ai détaillé cette méthode de mesure dans un article sur l’évaluation d’un assistant IA au support client. Le principe vaut pour toute tâche : un outil se juge sur des résultats mesurés, pas sur l’impression qu’il donne.
Turing l’avait compris avant tout le monde : imiter l’humain et avoir raison sont deux compétences différentes. Son test mesure la première. C’est à vous de mesurer la seconde.
Source primaire : A. M. Turing, « Computing Machinery and Intelligence », Mind, vol. 59, n° 236, octobre 1950, p. 433-460.
Dans la même série
Les autres épisodes des « ancêtres des LLM », par ordre chronologique :
- Ada Lovelace, 1843 : la machine « ne crée rien »
- Markov, 1913 : Pouchkine lettre par lettre
- Shannon, 1948 : un livre ouvert au hasard
- Dartmouth, 1956 : le premier devis IA sous-estimé
- Rosenblatt, 1958 : la promesse du Perceptron
- ELIZA, 1966 : une machine qui ne comprend rien
- Jelinek, années 1980 : la statistique bat la grammaire
- Asimov, 1991 : deux intelligences, pas une
Questions fréquentes
Qu’est-ce que le test de Turing ?
C’est le « jeu de l’imitation » décrit par Alan Turing dans « Computing Machinery and Intelligence » (Mind, 1950). Un interrogateur échange par écrit avec deux interlocuteurs qu’il ne voit pas, et doit deviner lequel est une machine. Turing prédisait que vers l’an 2000, un interrogateur moyen n’aurait pas plus de 70 % de chances de voir juste après cinq minutes de questions.
Une IA a-t-elle vraiment passé le test de Turing ?
Dans une étude préenregistrée publiée en mars 2025 par Cameron Jones et Benjamin Bergen (UC San Diego), GPT-4.5, avec une consigne de personnage, a été jugé humain 73 % du temps, plus souvent que les vrais humains. Sans cette consigne, il tombait à 36 %. Il s’agit d’une prépublication portant sur 284 participants et 1 023 parties.
Pourquoi réussir le test de Turing ne suffit-il pas pour faire confiance à une IA ?
Le test mesure si une machine paraît humaine, pas si elle a raison. Turing lui-même écrit que la machine introduirait délibérément des erreurs pour tromper l’interrogateur. En 2025, les interrogateurs jugeaient surtout le style ; connaissances et raisonnement n’étaient testés que dans 12 % des parties. Pour une organisation, un outil se juge sur des résultats mesurés sur ses propres tâches.