Claude Shannon, 1948 : le premier « modèle de langage » était un homme avec un livre
En 1948, Claude Shannon fabrique des phrases d’anglais plausible avec un livre, un doigt et beaucoup de patience. L’expérience tient en quatre gestes. Elle contient déjà le principe qui fait fonctionner ChatGPT, et aussi sa limite principale.
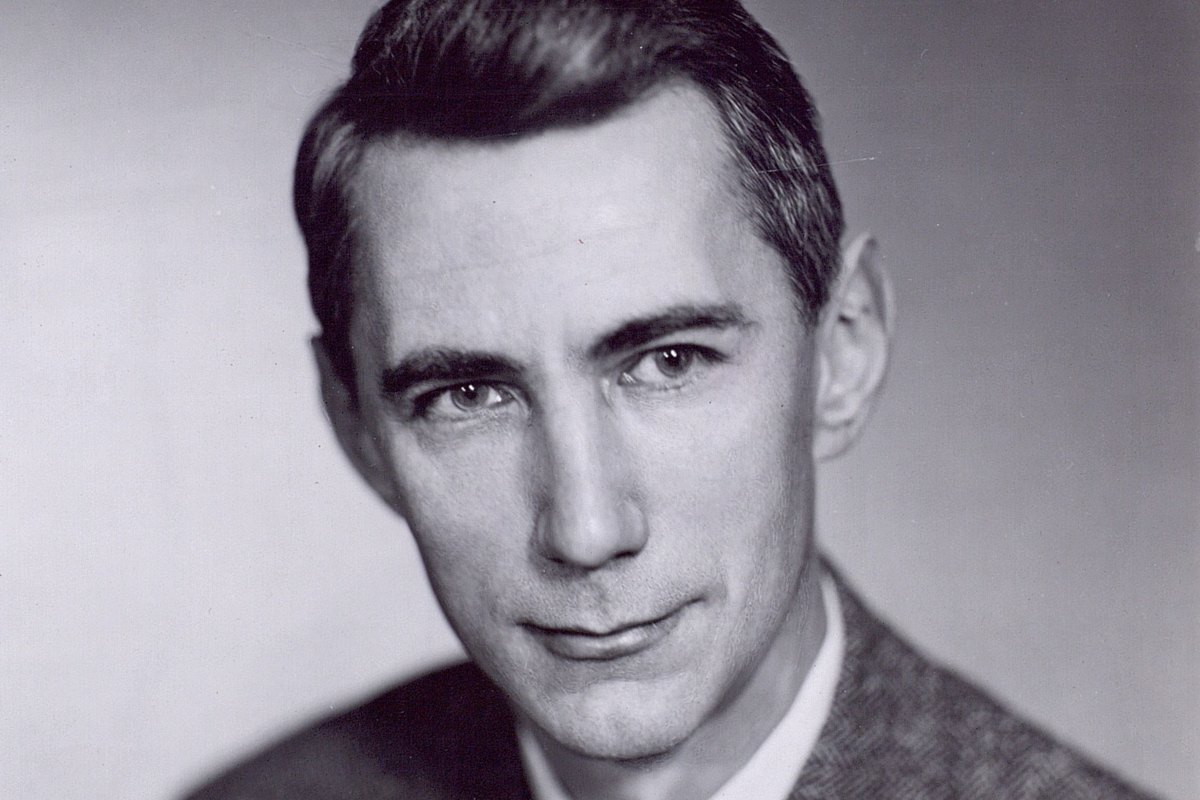
Je raconte souvent cette histoire en formation, parce qu’elle fait tomber une bonne partie du mystère autour des modèles de langage. Elle date de 1948, elle se passe aux Bell Labs, et elle ne demande ni ordinateur ni formule.
Un article qui fonde une discipline
En juillet et octobre 1948, Claude Shannon publie dans le Bell System Technical Journal un article en deux parties, « A Mathematical Theory of Communication ». Il y pose l’unité d’information, le bit, et montre comment mesurer la quantité d’information d’une source, la capacité d’un canal et la redondance d’un message. Les télécommunications, la compression et une bonne partie de l’informatique moderne partent de ces pages.
Pour illustrer l’idée de redondance, Shannon prend l’exemple de la langue anglaise. Un texte n’est pas une suite de lettres tirées au hasard : certaines lettres suivent plus souvent certaines autres, certains mots en appellent d’autres. Il propose une série d’« approximations » de l’anglais, de plus en plus fines, pour montrer à quel point ces dépendances structurent la langue.
L’expérience : un livre ouvert au hasard
Pour construire ces approximations sans machine, Shannon décrit une méthode manuelle. Je la cite d’après l’article, section 3 :
« To construct [3] for example, one opens a book at random and selects a letter at random on the page. This letter is recorded. The book is then opened to another page and one reads until this letter is encountered. The succeeding letter is then recorded. Turning to another page this second letter is searched for and the succeeding letter recorded, etc. »
Il précise qu’un procédé similaire a servi pour les approximations suivantes, dont celle par mots. En clair :
- Ouvrir un livre au hasard, choisir un mot.
- Ouvrir une autre page, lire jusqu’à retrouver ce mot.
- Noter le mot qui le suit.
- Recommencer avec ce nouveau mot.
Le livre sert de corpus. Le doigt qui cherche le mot et note le suivant fait office de modèle. La seule « mémoire » du système, c’est le dernier mot noté.
Le résultat : plausible, pas vrai
Voici la phrase que Shannon obtient avec cette méthode au niveau des mots, telle qu’elle est imprimée dans l’article (« second-order word approximation ») :
« THE HEAD AND IN FRONTAL ATTACK ON AN ENGLISH WRITER THAT THE CHARACTER OF THIS POINT IS THEREFORE ANOTHER METHOD FOR THE LETTERS THAT THE TIME OF WHO EVER TOLD THE PROBLEM FOR AN UNEXPECTED. »
La phrase n’a aucun sens. Mais chaque paire de mots est possible en anglais, et Shannon remarque que des suites de quatre mots ou plus « peuvent facilement être placées dans des phrases sans constructions inhabituelles ou forcées ». Il note même que la séquence « attack on an English writer that the character of this » n’est « pas du tout déraisonnable ».
C’est le point qui m’intéresse. Avec un seul mot de contexte et un seul livre, on obtient déjà quelque chose qui ressemble à de la langue. Pas du sens. De la ressemblance.
Ce qu’un LLM fait de plus, et ce qu’il ne fait pas de plus
Un modèle de langage comme ceux qui animent ChatGPT, Claude ou Gemini fait, au fond, la même opération : prédire le mot suivant à partir de ceux qui précèdent. Trois choses ont changé d’échelle.
- Le contexte. Shannon regarde un mot. Un LLM regarde des milliers de mots, toute la conversation et les documents qu’on lui fournit.
- Le corpus. Shannon a un livre. Un LLM a été entraîné sur une bibliothèque entière, dont une bonne partie du web.
- Le moteur. Shannon a un doigt. Un LLM a des milliards de paramètres ajustés pour que la prédiction soit la plus utile possible, puis affinés par des retours humains.
Ce qui n’a pas changé, c’est la nature de l’opération. Le modèle ne vérifie pas. Il n’a pas d’avis. Il produit la suite la plus probable compte tenu de ce qu’il a vu. Quand cette suite est aussi la vraie, parce que la question est bien documentée et le contexte fourni, le résultat est excellent. Quand elle ne l’est pas, le modèle produit l’équivalent de la phrase de Shannon : du plausible, écrit avec aplomb.
Je simplifie, bien sûr. Les modèles récents enchaînent des étapes de raisonnement, appellent des outils, consultent des sources. Mais chacune de ces étapes repose sur le même mécanisme de prédiction, et il est sain de le garder en tête quand on décide de ce qu’on leur confie.
Ce que ça change pour une organisation
Dans mes interventions, cette distinction entre plausible et vrai est le critère qui sépare les projets qui tiennent de ceux qui s’arrêtent après la démo. Trois conséquences pratiques.
1. Donner au modèle de quoi prédire juste
La phrase de Shannon est mauvaise parce que le contexte est pauvre. Un assistant qui répond sur vos procédures sans les avoir sous les yeux est dans la même situation. Fournir les documents, le vocabulaire maison, les exemples de bonnes réponses, c’est la part la plus rentable du travail, bien avant le choix du modèle.
2. Choisir des tâches où le plausible suffit, ou se vérifie
Reformuler, résumer, classer une demande, préparer un premier jet de devis : sur ces tâches, une sortie plausible fait gagner du temps, et l’erreur se voit. Décider seul d’un remboursement, d’un diagnostic ou d’une clause contractuelle : là, le plausible ne suffit pas, et il faut une vérification humaine ou une règle métier avant toute action.
3. Mesurer, parce que la ressemblance trompe
Un texte bien tourné fait baisser la vigilance. C’est pour cela qu’un projet IA se mesure sur un échantillon réel, avec un référentiel de bonnes réponses, avant et après la mise en service. J’en détaille la méthode dans pourquoi les POC IA ne passent pas en production.
Pourquoi cette histoire reste utile
On présente souvent les modèles de langage comme une rupture tombée du ciel en 2022. L’expérience de Shannon rappelle que le principe a 78 ans, qu’il tient sur une page, et qu’il a toujours eu la même limite. Ce n’est pas une raison de s’en méfier. C’est une raison de les utiliser pour ce qu’ils savent faire, avec le contexte qu’il faut et un humain là où ça compte.
Source : C. E. Shannon, « A Mathematical Theory of Communication », Bell System Technical Journal, vol. 27, 1948, section 3, « The Series of Approximations to English ». Citations vérifiées sur le texte de l’article.
Dans la même série
Les autres épisodes des « ancêtres des LLM », par ordre chronologique :
- Ada Lovelace, 1843 : la machine « ne crée rien »
- Markov, 1913 : Pouchkine lettre par lettre
- Turing, 1950 : le test, et la mauvaise question
- Dartmouth, 1956 : le premier devis IA sous-estimé
- Rosenblatt, 1958 : la promesse du Perceptron
- ELIZA, 1966 : une machine qui ne comprend rien
- Jelinek, années 1980 : la statistique bat la grammaire
- Asimov, 1991 : deux intelligences, pas une
Questions fréquentes
Shannon a-t-il inventé la prédiction du mot suivant ?
Non. Il s’appuie sur les processus décrits par Andreï Markov dès 1913 et cite explicitement les « processus de Markoff ». Son apport est de les appliquer à la langue avec une méthode concrète, puis d’en tirer une mesure de l’information. Les modèles de langage actuels prolongent cette idée à une échelle incomparable.
Un LLM se contente-t-il vraiment de prédire le mot suivant ?
Le cœur du mécanisme, oui. Les modèles récents y ajoutent des étapes de raisonnement, l’appel à des outils et des retours humains lors de l’entraînement, ce qui améliore beaucoup l’utilité des réponses. Mais aucune de ces couches ne transforme une prédiction en vérification : c’est à l’organisation de prévoir cette vérification quand elle compte.
Quelles tâches confier en premier à un modèle de langage dans une PME ?
Celles où une réponse plausible fait gagner du temps et où l’erreur se voit vite : reformuler, résumer, trier des demandes, préparer un premier jet. Fournir au modèle les documents et le vocabulaire de l’entreprise, puis mesurer sur un échantillon réel avant d’élargir.