Markov, 1913 : le mathématicien qui a lu Pouchkine lettre par lettre, bien avant les LLM
Avant Shannon, avant les ordinateurs, un mathématicien russe a compté au crayon les voyelles et les consonnes d’un roman en vers. Il voulait gagner une querelle de théorie. Il a posé la question que les modèles de langage se posent encore à chaque mot.
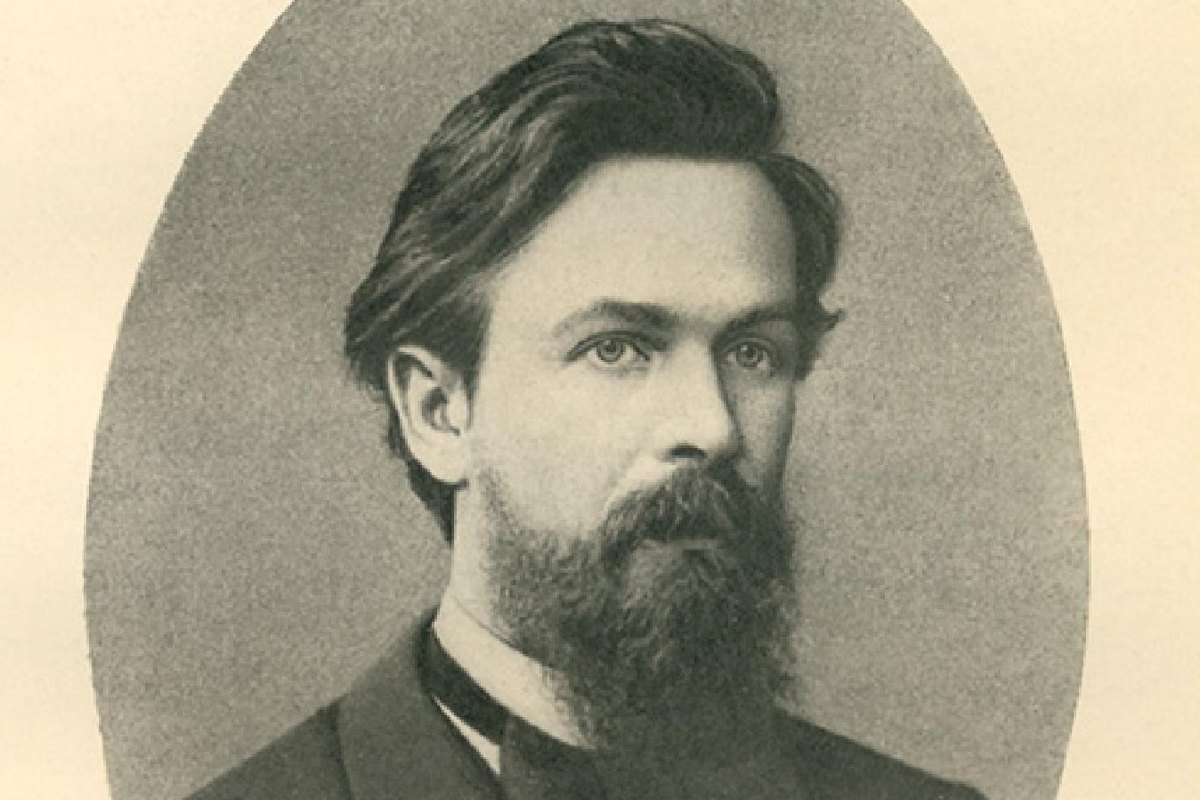
Quand on m’explique qu’un LLM « prédit le mot suivant », je pense à un homme qui n’a jamais vu d’ordinateur. En janvier 1913, à Saint-Pétersbourg, le mathématicien Andreï Markov présente à l’Académie des sciences le résultat d’un travail étrange : il a compté, au crayon, les voyelles et les consonnes des 20 000 premières lettres d’« Eugène Onéguine », le roman en vers de Pouchkine.
Ce travail ne dit rien de la poésie de Pouchkine. Il dit quelque chose de beaucoup plus général : dans un texte, ce qui vient dépend de ce qui précède. Cent treize ans plus tard, c’est toujours l’idée qui fait tourner les modèles de langage.
Une querelle de mathématiciens
Markov ne cherchait pas à comprendre la littérature. Il voulait gagner une dispute. Selon le journaliste scientifique Brian Hayes, dans American Scientist, son adversaire était Pavel Nekrassov, mathématicien à Moscou, qui avait soutenu en 1902 que la loi des grands nombres ne s’applique qu’à des événements indépendants. Il en tirait une conclusion théologique : si les statistiques sociales obéissent à cette loi, c’est que les actes humains sont indépendants, donc libres.
Markov conteste le raisonnement, pas la théologie. Dès 1906, il montre que la loi des grands nombres vaut aussi pour des événements liés entre eux, à condition qu’ils forment ce qu’on appellera plus tard une chaîne : une suite où la probabilité de l’étape suivante dépend de l’étape présente. Il lui manque une chose : un exemple réel. Pendant des années, il s’en désintéresse ouvertement. Il écrit à son collègue Tchouprov qu’il s’occupe « seulement de questions d’analyse pure ». En 1913, il change d’avis et choisit un texte que tous les écoliers russes connaissent.
Ce que Markov a fait, étape par étape
Sa conférence du 23 janvier 1913 est traduite en anglais et publiée en 2006 dans la revue Science in Context (traduction de Nitussov, Voropai, Custance et Link). La méthode y est décrite avec précision :
- Le corpus. Les 20 000 premières lettres du roman, soit tout le premier chapitre et seize strophes du deuxième, sans les signes dur et mou, qui ne se prononcent pas.
- Le découpage. Les lettres, recopiées sans espaces ni ponctuation, sont rangées en 200 carrés de dix lignes sur dix colonnes.
- Le comptage. 8 638 voyelles et 11 362 consonnes. La proportion de voyelles est donc de 0,432.
- Les paires. Markov compte les cas où une voyelle suit une voyelle : 1 104. Il en déduit 3 827 paires de consonnes, sans les recompter une par une.
Brian Hayes, qui a refait une partie de l’exercice sur une traduction anglaise, estime que Markov a dû y passer plusieurs jours. Lui-même a raté 62 des 248 paires de voyelles de son échantillon. Markov reprendra ensuite la méthode sur 100 000 caractères d’un récit de Sergueï Aksakov.
Le résultat : la lettre suivante n’est pas un hasard pur
Si les lettres étaient indépendantes, une voyelle suivrait une voyelle avec la même probabilité qu’ailleurs, environ 43 %. Hayes calcule qu’on attendrait alors environ 3 731 paires de voyelles. Markov en trouve 1 104, plus de trois fois moins.
Ses deux chiffres clés tiennent en une ligne. Après une voyelle, la lettre suivante est une voyelle dans 12,8 % des cas. Après une consonne, dans 66,3 %. Sa conclusion, dans la traduction anglaise :
As we can see, the probability of a letter being a vowel changes considerably depending upon which letter – vowel or consonant – precedes it.
Autrement dit : connaître la lettre présente change la prévision de la suivante. Un texte n’est pas une suite de tirages au sort. C’est une suite d’états liés, avec des probabilités de passage d’un état à l’autre. C’est la définition d’une chaîne de Markov.
De Pouchkine aux LLM
Le lien avec l’IA d’aujourd’hui passe par Claude Shannon. En 1948, dans « A Mathematical Theory of Communication », il génère des phrases artificielles en choisissant chaque lettre, puis chaque mot, selon ce qui précède. Il précise que ces processus sont connus en mathématiques sous le nom de « processus de Markoff discrets ». La graphie a changé, l’idée non.
Un modèle de langage moderne fait la même opération, à une autre échelle. Markov regardait une seule lettre en arrière et ne connaissait que deux états, voyelle ou consonne. Un LLM regarde des milliers de mots en arrière et choisit parmi tout un vocabulaire de fragments de mots. Mais la question posée à chaque pas est identique : étant donné ce qui précède, qu’est-ce qui vient ensuite, le plus probablement ?
Je trouve utile de garder cette filiation en tête, parce qu’elle rappelle ce qu’un modèle de langage est, et ce qu’il n’est pas. Il a appris ce qui suit d’habitude. Il n’a pas appris ce qui est vrai.
Ce que ça change pour une organisation
Dans mes missions, cette leçon de 1913 se traduit en trois décisions concrètes.
Choisir des tâches où « d’habitude » suffit
Un modèle qui connaît ce qui suit d’habitude est fiable sur les tâches répétitives et bien documentées : répondre aux questions fréquentes, trier les demandes entrantes, rédiger le premier jet d’un devis ou d’un compte rendu. Plus la tâche ressemble à ce qu’il a déjà vu, et plus vos propres documents lui sont fournis, meilleur il est.
Prévoir un humain sur les exceptions
Le même modèle est faible sur ce qui sort de l’ordinaire : un litige, un client mécontent, un cas hors procédure. Là, la suite la plus probable n’est pas la bonne réponse. Il faut décider à l’avance qui reprend la main, sur quels critères, et comment l’escalade se déclenche.
Mesurer, puis désigner un propriétaire métier
Markov n’a pas affirmé que les lettres étaient liées : il l’a compté. La même discipline s’applique à un projet IA. Un taux de réponses correctes, un volume traité, un temps de traitement, mesurés avant et après. Et une personne, côté métier, responsable du résultat. C’est souvent ce qui manque quand un projet reste bloqué au stade du prototype, comme je l’explique dans pourquoi les POC IA n’arrivent pas en production.
Ce que je retiens
Markov a passé des jours sur 20 000 lettres pour gagner une querelle de théorie. Il n’a jamais cherché à faire écrire une machine. Mais il a posé la bonne question, celle que se posent encore les modèles de langage à chaque mot qu’ils produisent. La réponse la plus probable est souvent la bonne. Le travail d’une organisation consiste à savoir quand elle ne l’est pas.
Dans la même série
Les autres épisodes des « ancêtres des LLM », par ordre chronologique :
- Ada Lovelace, 1843 : la machine « ne crée rien »
- Shannon, 1948 : un livre ouvert au hasard
- Turing, 1950 : le test, et la mauvaise question
- Dartmouth, 1956 : le premier devis IA sous-estimé
- Rosenblatt, 1958 : la promesse du Perceptron
- ELIZA, 1966 : une machine qui ne comprend rien
- Jelinek, années 1980 : la statistique bat la grammaire
- Asimov, 1991 : deux intelligences, pas une
Questions fréquentes
Qu’a fait Markov avec Eugène Onéguine ?
En 1913, il a analysé les 20 000 premières lettres du roman de Pouchkine, sans espaces ni ponctuation. Il a compté 8 638 voyelles et 11 362 consonnes, puis les paires de lettres. Après une voyelle, la lettre suivante est une voyelle dans 12,8 % des cas ; après une consonne, dans 66,3 %.
Quel est le lien entre une chaîne de Markov et un LLM ?
Une chaîne de Markov prédit l’état suivant à partir de l’état présent. Un LLM prédit le mot suivant à partir des mots qui précèdent. Shannon, en 1948, appelait déjà ses textes générés des « processus de Markoff ». La différence tient à l’échelle : une lettre de contexte chez Markov, des milliers de mots pour un LLM.
Qu’est-ce que cela implique pour une entreprise qui utilise l’IA ?
Un modèle de langage sait ce qui suit d’habitude, pas ce qui est vrai. Il est fiable sur les tâches répétitives et bien documentées. Sur les exceptions, il faut un humain désigné, des critères d’escalade et une mesure du résultat.