ELIZA, 1966 : pourquoi on fait confiance à une machine qui ne comprend rien
En 1966, un programme du MIT, fait de mots-clés et de règles de réécriture, imite un psychothérapeute. La secrétaire de son inventeur, qui sait que c’est un programme, lui demande de sortir pour lui parler seule. Soixante ans plus tard, la leçon vaut pour chaque assistant IA.
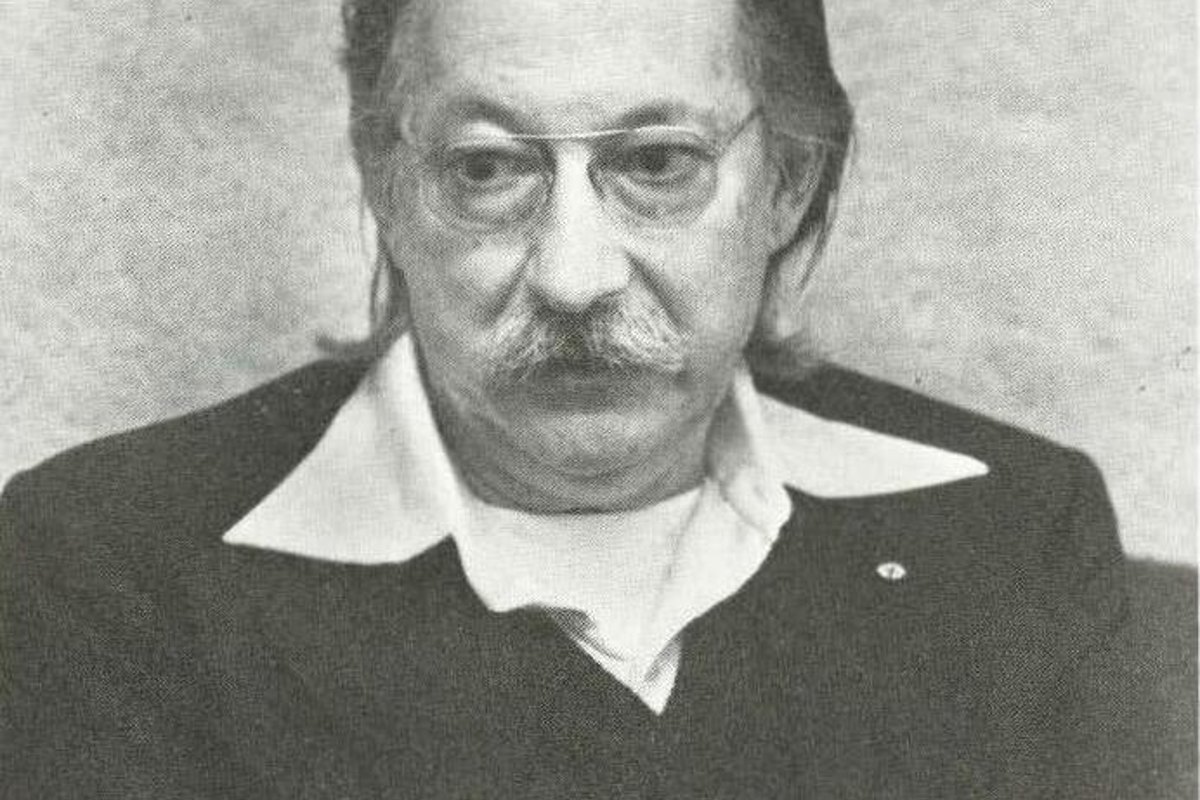
En 1966, Joseph Weizenbaum, chercheur au MIT, publie dans Communications of the ACM un article de dix pages sur un programme baptisé ELIZA. On tape une phrase sur une machine à écrire reliée à l’ordinateur, et l’ordinateur répond. Rien de plus. Et pourtant, soixante ans avant ChatGPT, des gens confient déjà leurs soucis à une machine.
Ce qui m’intéresse dans cette histoire n’est pas la prouesse technique. C’est ce qu’elle dit de nous, et de la façon dont une organisation devrait décider de faire confiance à un assistant IA.
Un programme qui joue au psychothérapeute
ELIZA tourne sur le système à temps partagé du MIT, sur un IBM 7094. Le programme lui-même ne sait rien : il applique un script. Le plus connu, DOCTOR, fait répondre la machine à la manière d’un psychothérapeute rogérien, celui qui relance son patient en reformulant ce qu’il vient de dire.
Le choix n’a rien d’un hasard. Weizenbaum l’explique dans l’article : l’entretien psychiatrique est l’une des rares conversations où l’un des deux interlocuteurs peut « prendre la pose de ne presque rien savoir du monde réel ». Si vous dites à un psy « j’ai fait une longue promenade en bateau » et qu’il répond « parlez-moi des bateaux », vous ne pensez pas qu’il ignore ce qu’est un bateau. Vous pensez qu’il a une raison de poser la question. C’est vous qui comblez le vide.
L’article reproduit une conversation type. Les lignes en majuscules sont celles de la machine :
Men are all alike.
IN WHAT WAY
They're always bugging us about something or other.
CAN YOU THINK OF A SPECIFIC EXAMPLE
Well, my boyfriend made me come here.
YOUR BOYFRIEND MADE YOU COME HERE
Un détail : aucune réponse ne se termine par un point d’interrogation. Sur ce système, le « ? » servait à effacer la ligne. La machine pose des questions sans jamais pouvoir les marquer comme telles, et personne ne s’en formalise.
Le mécanisme : des mots-clés et des règles de réécriture
Le fonctionnement tient en quatre étapes, décrites en détail dans l’article de 1966 :
- Repérer un mot-clé dans la phrase de l’utilisateur, par ordre de priorité (« mother », « I am », « you »…).
- Décomposer la phrase selon un modèle associé à ce mot-clé.
- La réassembler avec une formule toute faite, en inversant les pronoms : « I » devient « YOU », « me » devient « you ».
- À défaut de mot-clé, sortir une phrase passe-partout, comme « PLEASE GO ON ».
Le code original, longtemps considéré comme perdu, a été retrouvé en 2021 par Jeff Shrager et l’archiviste du MIT Myles Crowley dans les archives de Weizenbaum. La succession l’a placé sous licence CC0. Selon Shrager, le programme principal fait environ 230 lignes. Pas de base de connaissances, pas de mémoire durable des échanges. Weizenbaum le dit lui-même : ELIZA jette chacune des phrases qu’on lui donne, à quelques exceptions près.
La secrétaire qui demande à rester seule
La suite, Weizenbaum la raconte dix ans plus tard, dans Computer Power and Human Reason (1976). Il est surpris de voir à quelle vitesse les utilisateurs de DOCTOR s’attachent émotionnellement au programme. Puis vient l’anecdote :
« Once my secretary, who had watched me work on the program for many months and therefore surely knew it to be merely a computer program, started conversing with it. After only a few interchanges with it, she asked me to leave the room. »
Sa secrétaire l’avait vu travailler sur le programme pendant des mois. Elle savait que c’était un programme. Après quelques échanges, elle lui a demandé de quitter la pièce. Quand il évoque l’idée de relire les conversations de la nuit, on l’accuse d’espionner les pensées les plus intimes des gens.
Il en tire une conclusion qu’il ne lâchera plus : de très courtes expositions à un programme relativement simple peuvent induire, chez des gens tout à fait normaux, une « pensée délirante ». Le choc vient aussi de ses pairs : des psychiatres imaginent que DOCTOR pourrait devenir une forme presque automatique de psychothérapie, capable, selon un texte qu’il cite, de traiter « plusieurs centaines de patients par heure ». Weizenbaum passera le reste de sa carrière à mettre en garde contre la tentation de déléguer le jugement à des machines.
Ce que Weizenbaum avait déjà écrit en 1966
On retient surtout de Weizenbaum ses mises en garde des années 1970. En relisant l’article original, je constate que l’essentiel y est déjà. Deux phrases, en particulier :
« ELIZA shows, if nothing else, how easy it is to create and maintain the illusion of understanding, hence perhaps of judgment deserving of credibility. A certain danger lurks there. »
ELIZA montre à quel point il est facile de créer et d’entretenir l’illusion de la compréhension, et donc peut-être d’un jugement digne de confiance. Et il ajoute que des décisions importantes sont de plus en plus prises sur la base de ce que dit la machine.
La seconde phrase est celle que je cite le plus souvent en mission :
« The crucial test of understanding, as every teacher should know, is not the subject's ability to continue a conversation, but to draw valid conclusions from what he is being told. »
Le test décisif de la compréhension n’est pas la capacité à poursuivre une conversation, mais à tirer des conclusions valides de ce qu’on vous dit.
Le lien avec les LLM d’aujourd’hui
Un LLM n’a rien à voir techniquement avec ELIZA. Il ne cherche pas de mots-clés : il prédit la suite d’un texte à partir de milliards d’exemples, et il le fait avec une fluidité qu’ELIZA n’a jamais approchée. Il sait des choses, au sens où son entraînement a absorbé une quantité énorme d’information.
Mais l’effet décrit par Weizenbaum, qu’on appelle aujourd’hui l’effet ELIZA, est plus fort, pas plus faible. Plus la conversation est fluide, plus nous prêtons à l’interlocuteur une compréhension, et donc un jugement. Un modèle qui répond avec assurance à une question sur un délai de livraison donne la même impression qu’un collègue qui connaît le dossier. Il n’a pourtant vérifié ni le stock ni le contrat, sauf si quelqu’un l’a branché dessus.
Ce que ça change pour une organisation
Quand une équipe me montre un assistant IA « qui marche bien », je pose presque toujours la même question : comment le savez-vous ? Trop souvent, la réponse est une démonstration. Une conversation convaincante. C’est exactement le critère que Weizenbaum écartait en 1966.
Avant de laisser un assistant parler à des clients, je demande trois choses par écrit :
- Ce qu’il doit vérifier avant de répondre, et dans quelle source : stock, prix, délais, conditions du contrat, historique du client.
- Ce qu’il n’a pas le droit d’affirmer : un engagement de délai, un geste commercial, un diagnostic. Dans ces cas, il transmet à un humain.
- Qui contrôle ses réponses, à quel rythme, et sur quel échantillon. Un propriétaire métier, nommé, pas « l’équipe IA ».
Le contrôle se mesure : taux de réponses justes sur un échantillon relu, taux d’escalade, erreurs signalées par les clients. J’ai détaillé ces indicateurs dans mesurer un assistant IA de support client. Sans eux, vous jugez votre outil comme la secrétaire de Weizenbaum jugeait DOCTOR : à l’impression qu’il vous comprend.
Ce que je retiens de Weizenbaum : savoir ce qu’une machine fait réellement avant de lui confier une décision. Soixante ans plus tard, c’est toujours la bonne question à poser à un projet IA.
Source primaire : J. Weizenbaum, « ELIZA—A Computer Program For the Study of Natural Language Communication Between Man and Machine », Communications of the ACM, vol. 9, n° 1, janvier 1966, p. 36-45.
Dans la même série
Les autres épisodes des « ancêtres des LLM », par ordre chronologique :
- Ada Lovelace, 1843 : la machine « ne crée rien »
- Markov, 1913 : Pouchkine lettre par lettre
- Shannon, 1948 : un livre ouvert au hasard
- Turing, 1950 : le test, et la mauvaise question
- Dartmouth, 1956 : le premier devis IA sous-estimé
- Rosenblatt, 1958 : la promesse du Perceptron
- Jelinek, années 1980 : la statistique bat la grammaire
- Asimov, 1991 : deux intelligences, pas une
Questions fréquentes
Qu’est-ce que l’effet ELIZA ?
C’est la tendance à prêter de la compréhension, et donc du jugement, à un programme qui converse de façon plausible. Weizenbaum l’observe dès 1966 avec ELIZA, un programme qui ne fait que repérer des mots-clés et reformuler les phrases de l’utilisateur.
ELIZA fonctionnait-il comme un LLM ?
Non. ELIZA applique des règles écrites à la main : un mot-clé déclenche une reformulation. Un LLM prédit la suite d’un texte à partir d’un apprentissage sur d’immenses corpus. Le point commun est ailleurs : dans les deux cas, la fluidité de la conversation ne garantit pas que la réponse soit juste.
Comment éviter l’effet ELIZA avec un assistant IA en entreprise ?
En définissant par écrit ce que l’assistant doit vérifier avant de répondre, ce qu’il n’a pas le droit d’affirmer, et qui relit ses réponses, à quel rythme et sur quel échantillon. On juge alors l’outil sur des indicateurs mesurés, pas sur l’impression laissée par une démonstration.